Methodik
Wie aus einer Idee ein Handelssystem wird, dem man vertrauen kann
Ein Handelssystem ist schnell programmiert. Ein Handelssystem, das unter echten Bedingungen genau das tut, was der Test versprochen hat, ist etwas ganz anderes.
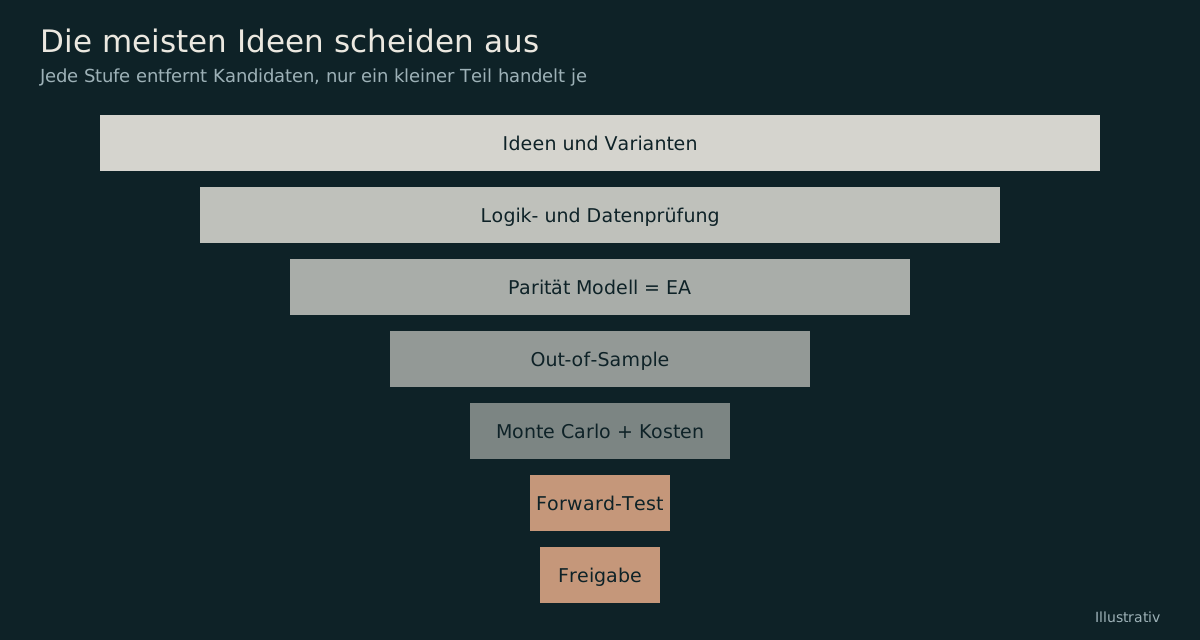
Zwischen beidem liegen Hunderte von Prüfschritten, Tausende von Testläufen und eine Disziplin, die keine Abkürzung erlaubt. Diese Seite zeigt nicht, was unsere Systeme handeln. Sie zeigt, wie wir arbeiten: welche Prüfungen ein System bestehen muss, bevor es auch nur auf einem Demokonto läuft, und warum fast alle Ideen auf diesem Weg ausscheiden.
Grundsatz
Ein Ergebnis zählt erst, wenn es jeder Gegenprobe standhält
Eine schöne Kurve im Backtest beweist nichts. Sie kann entstehen, weil das System versehentlich in die Zukunft schaut, weil die Kosten zu niedrig angesetzt sind, weil ein einzelner Glückstreffer alles trägt oder weil der Test auf den falschen Daten lief. Jede dieser Fehlerquellen haben wir in der Praxis erlebt. Für jede gibt es bei uns heute eine eigene, feste Prüfung.
- Nichts wird geschätzt, alles wird gemessen. Jedes Ergebnis nennt seine Grundlage: Zeitraum, Datenquelle, Kostenmodell, Version.
- Vorher festlegen, dann prüfen. Was als Erfolg gilt, steht fest, bevor der Test läuft. Nachträgliches Schönrechnen ist damit ausgeschlossen.
- Jede Messung braucht einen Vergleichsmassstab. Ein Ergebnis ist nur dann etwas wert, wenn es besser ist als das, was der Zufall unter gleichen Bedingungen geliefert hätte (Nullmodell).
- Nie überschreiben, immer hochzählen. Jede Version, jede Einstellung und jeder Bericht bleibt erhalten und ist nachvollziehbar.
- Ein gefundener Fehler wird nicht nur notiert. Er bekommt eine Ursache, eine Korrektur und einen eigenen Test, damit er nie wiederkommt.
Prüfkette
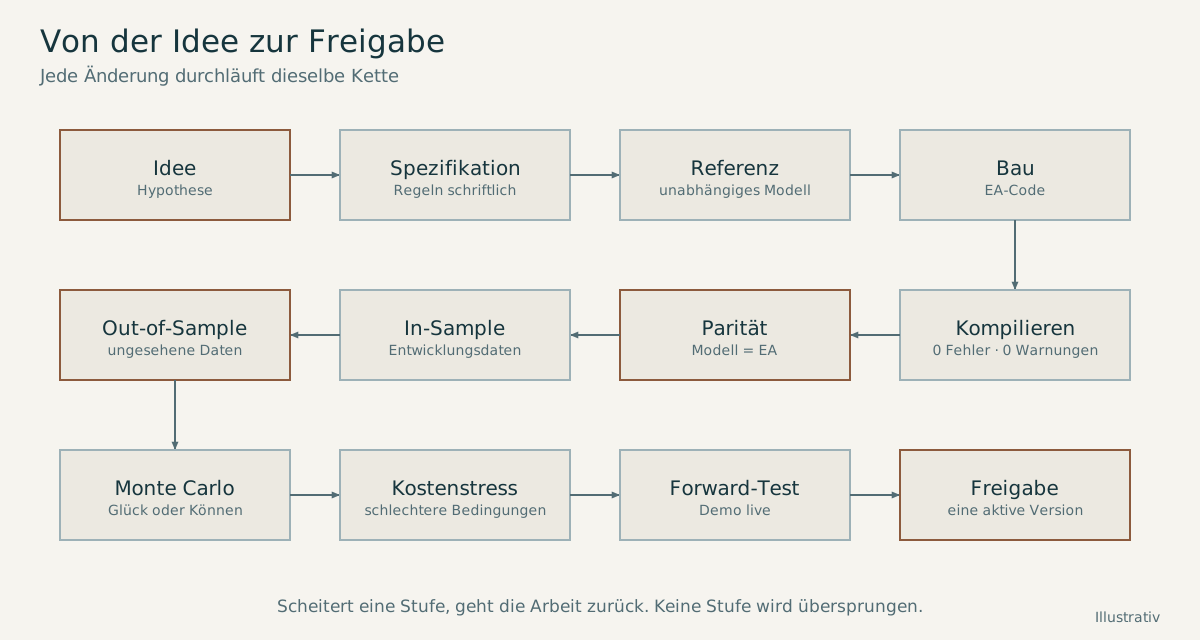
Der Weg einer Idee
- 01
Spezifikation vor Code
Bevor eine Zeile Code entsteht, wird die Regel schriftlich festgehalten und freigegeben. Was nicht eindeutig beschrieben ist, kann auch nicht eindeutig geprüft werden.
Was das für Sie heisst: Sie wissen vorab genau, was ein System tun soll, und können es später daran messen.
- 02
Zwei unabhängige Umsetzungen
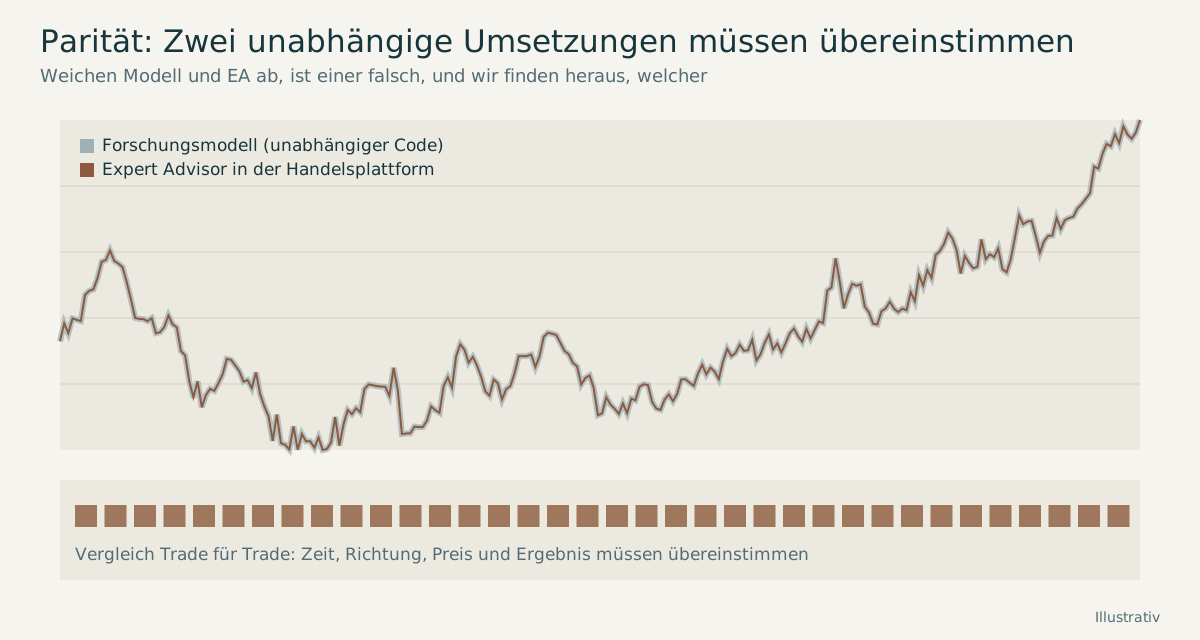
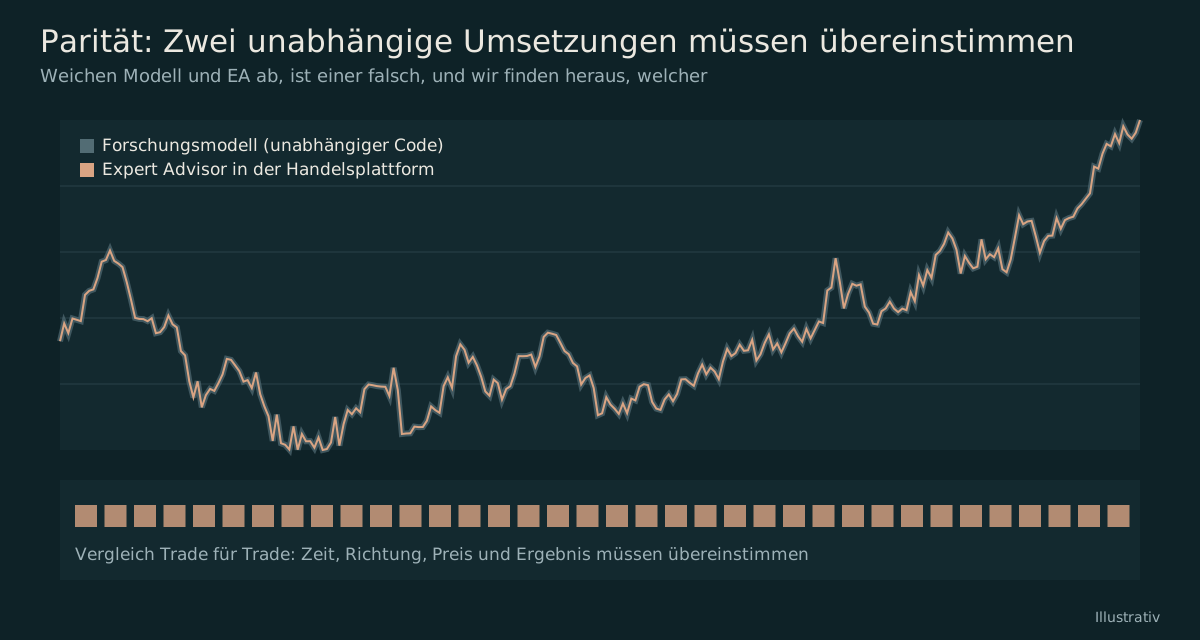
Jede Strategie existiert bei uns doppelt: als Forschungsmodell in einer eigenen Analyse-Umgebung und als Expert Advisor in der Handelsplattform. Beide werden unabhängig voneinander gebaut. Erst wenn beide Trade für Trade dasselbe Ergebnis liefern, gilt die Umsetzung als korrekt. Weichen sie ab, ist einer der beiden falsch, und wir suchen so lange, bis klar ist, welcher.
Diese Paritätsprüfung hat bei uns unter anderem gefunden: Signale, die am Anfang statt am Ende einer Kerze ausgewertet wurden; verworfene Wochenend-Kerzen; abweichende Rundungen gegenüber dem Broker; eine Terminliste, die im Test früher endete als im Live-Betrieb; und Einstellungen, die im System gar keine Wirkung hatten.
Was das für Sie heisst: Ein Fehler in unserer Arbeit fällt auf, weil zwei unabhängige Rechnungen dasselbe liefern müssen.
- 03
Kompilieren ohne jede Warnung
Der Code muss ohne einen einzigen Fehler und ohne eine einzige Warnung übersetzt werden. Das wird nicht angenommen, sondern bei jedem Build tatsächlich ausgeführt und abgelesen.
Was das für Sie heisst: Kein Programm geht in den Test, das schon beim Übersetzen Warnungen erzeugt.
- 04
Der Blick-in-die-Zukunft-Test
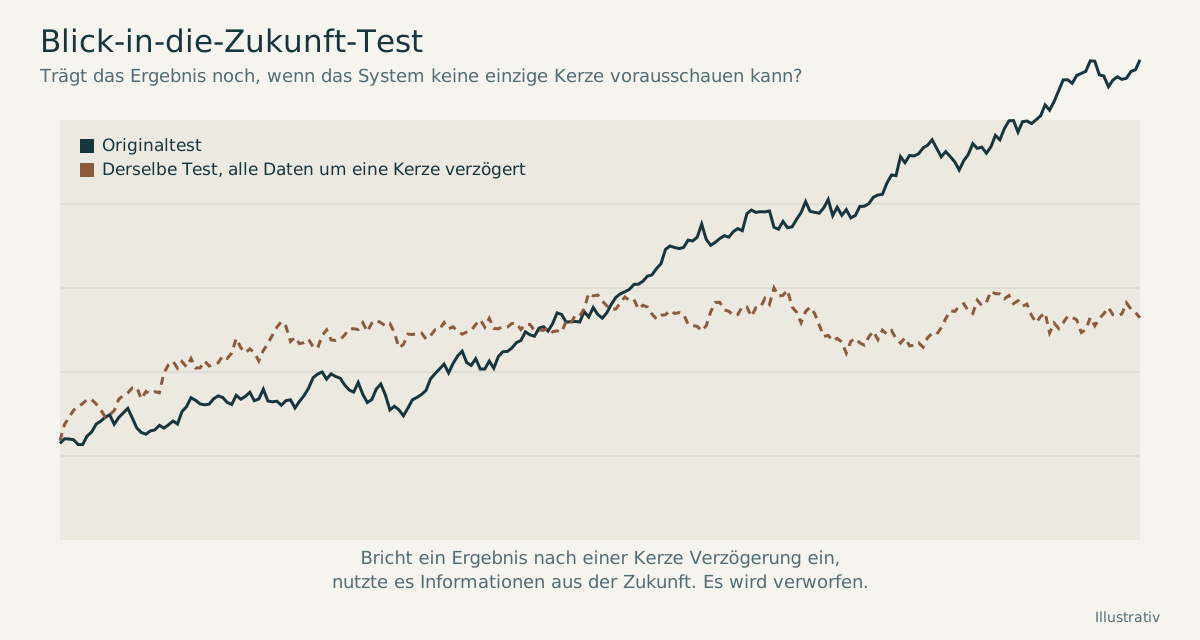
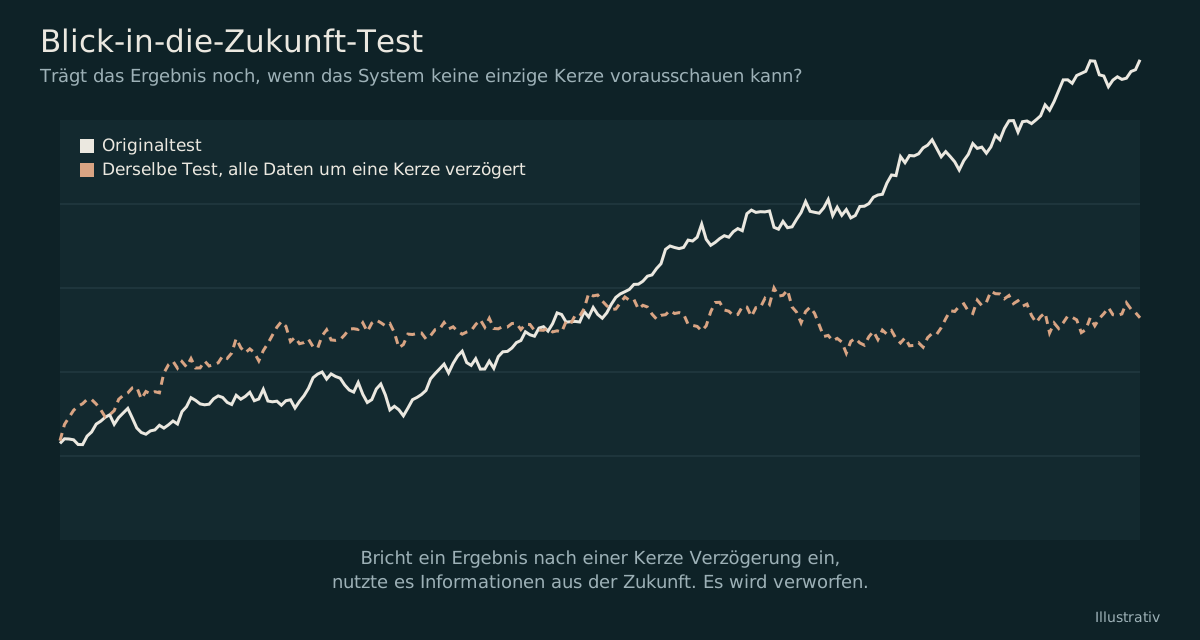
Der gefährlichste Fehler im Backtest ist unsichtbar: Das System nutzt eine Information, die es im echten Handel zu diesem Zeitpunkt noch gar nicht hätte. Wir verzögern deshalb alle Daten künstlich um eine weitere Kerze. Bricht das Ergebnis danach ein, hat das System in die Zukunft geschaut, und die Idee ist erledigt.
Was das für Sie heisst: Ein Ergebnis, das nur dank unmöglichem Vorauswissen gut aussieht, erreicht Sie nie.
- 05
Entwicklungsdaten und Prüfdaten bleiben getrennt
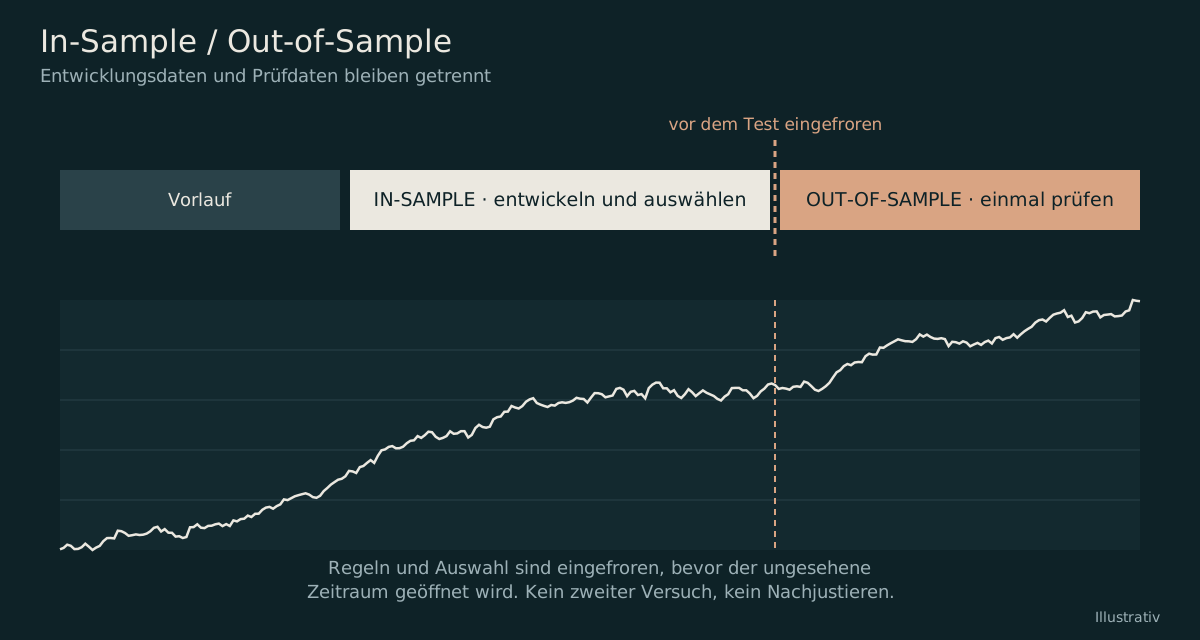
Dieser Schritt ist einer der wichtigsten und wird von vielen unterschätzt. Wer ein System auf der gesamten Historie entwickelt und dieselbe Historie zur Bewertung nutzt, kann fast jedes System passend machen: Parameter werden so lange gedreht, bis die Vergangenheit schön aussieht. Im Bericht wirkt das überzeugend, im Live-Handel bricht es oft zusammen. Dieses Vorgehen heisst Overfitting. Manche Entwickler nutzen es bewusst, viele unbewusst.
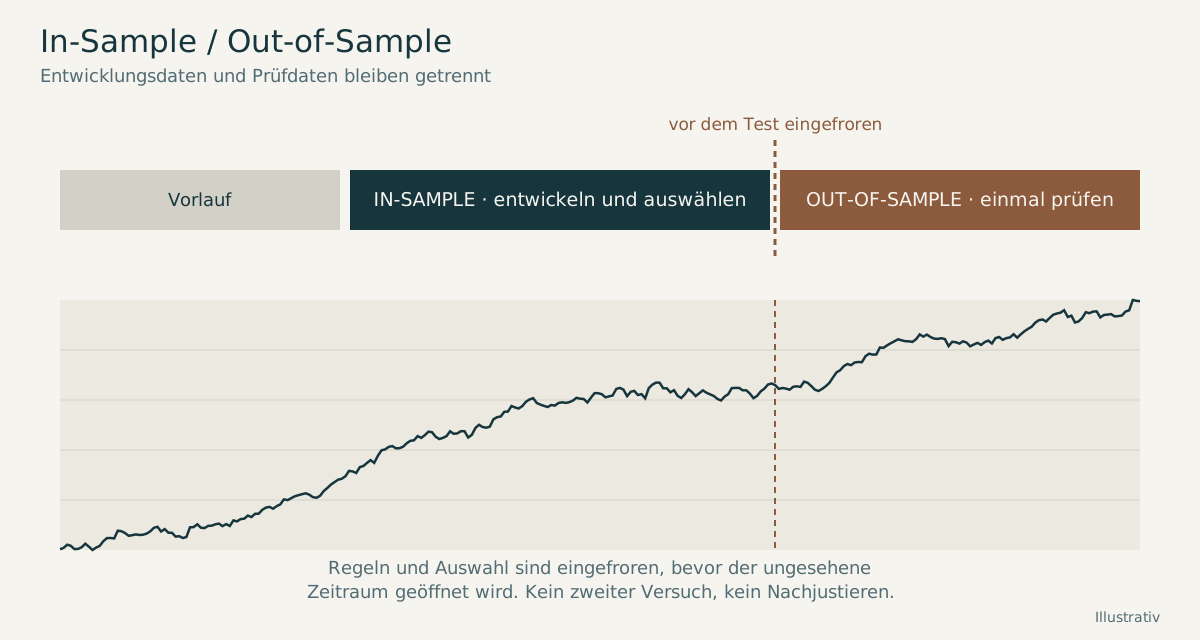
Wir trennen deshalb zwei Zeiträume. Auf dem ersten (In-Sample) wird entwickelt und ausgewählt. Der zweite (Out-of-Sample) bleibt bis zum Schluss verschlossen. Erst wenn Regeln und Auswahl eingefroren sind, wird er genau einmal geöffnet. Es gibt keinen zweiten Versuch und kein Nachjustieren. Besteht eine Idee hier nicht, wird sie nicht repariert, sondern verworfen.
Der Vorteil: Für das System verhält sich der Prüfzeitraum wie eine echte Zukunft. Es hat ihn nie gesehen, und er wird Tick für Tick mit echten Marktdaten (Datenqualität 99,9 %), Spread und Kosten durchgespielt. So bilden wir unsere Entwicklung in einer wirklichkeitsnahen, zu 99,9 % tickbasierten Zukunft ab, noch bevor Kapital im Live-Handel riskiert wird. Das ist kein Optimieren auf die Vergangenheit, sondern der Gegenbeweis dazu.
Auch dieser Nachweis ist keine Renditezusage. Er zeigt, ob ein System ausserhalb seiner Entwicklungsdaten trägt, und damit, ob es mehr ist als ein gut angepasstes Muster.
Was das für Sie heisst: Was Sie sehen, wurde an Daten bestätigt, die beim Entwickeln nicht zur Verfügung standen.
- 06
Monte Carlo: Wie viel war Glück?
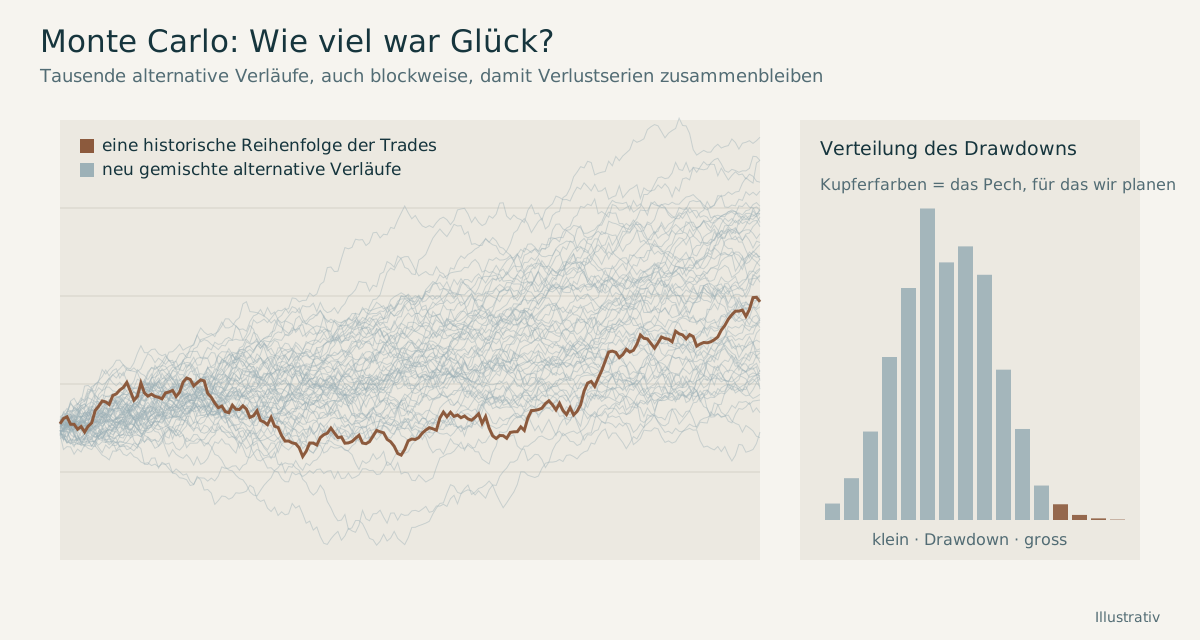
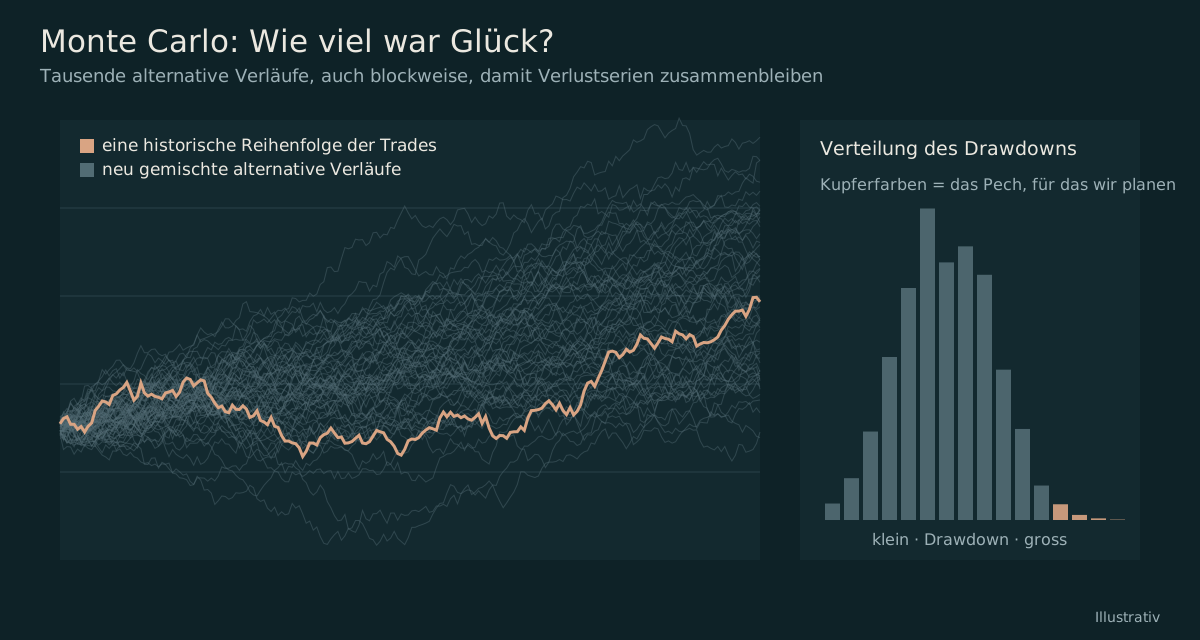
Die Geschichte ist nur eine von vielen möglichen Abfolgen. Wir erzeugen Tausende alternative Verläufe aus denselben Trades: einzeln gemischt, gezogen mit Zurücklegen und blockweise vertauscht, sodass zusammenhängende Verlustphasen erhalten bleiben. Daraus sehen wir, welcher Rückgang realistisch ist und wie wahrscheinlich ein Verlust gewesen wäre. Gerade die blockweise Variante zeigt, dass Risiken deutlich unterschätzt werden, wenn man Trades nur einzeln mischt.
Was das für Sie heisst: Sie sehen nicht nur den einen Verlauf der Vergangenheit, sondern auch, wie schlecht es bei anderer Reihenfolge hätte laufen können.
- 07
Kostenstress
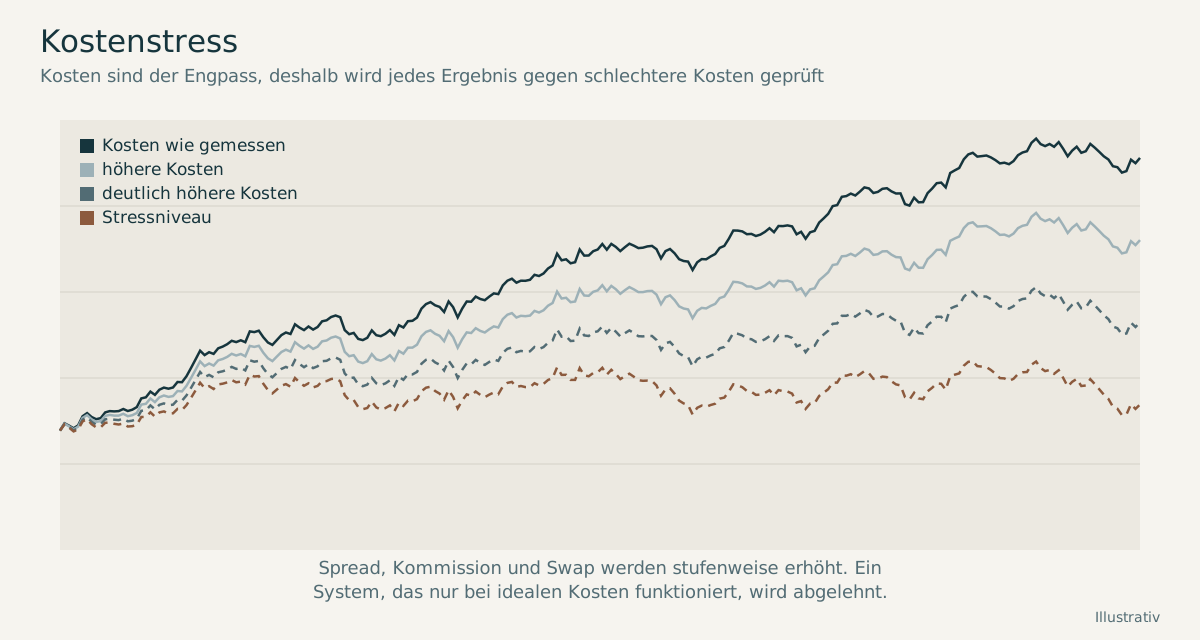
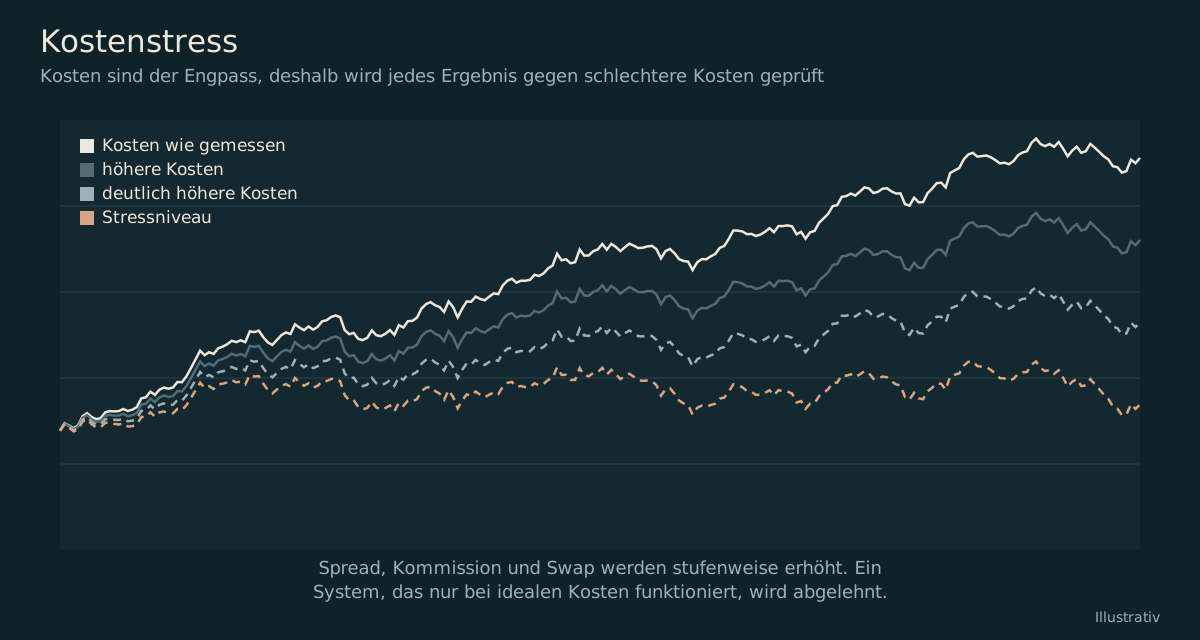
Kosten (Spread, Kommission, Swap) sind der eigentliche Engpass jedes Handelssystems. Jedes Ergebnis wird deshalb mit stufenweise höheren Kosten erneut gerechnet. Ein System, das nur bei idealen Kosten funktioniert, wird abgelehnt.
Was das für Sie heisst: Ein System muss auch bei schlechteren Handelsbedingungen als heute tragfähig sein, sonst wird es nicht freigegeben.
- 08
Robust statt optimal
Wir suchen nicht die eine beste Einstellung, sondern stabile Bereiche: Ein Ergebnis muss auch bei benachbarten Einstellungen tragen, über verschiedene Marktphasen bestehen und darf nicht von wenigen Jahren oder einem einzelnen Trade abhängen. Jede Kapitalkurve und jede Jahresverteilung wird zusätzlich mit dem Auge geprüft, denn manche Schwächen sieht man in keiner Kennzahl.
Was das für Sie heisst: Kein Ergebnis hängt an einem Zufallstreffer oder an einer einzigen Einstellung.
- 09
Forward-Test unter echten Bedingungen
Erst nach allen Prüfungen läuft ein System auf Demokonten bei echten Brokern. Der Start folgt einer Checkliste, deren Punkte einzeln belegt werden. Die Einstiege im Live-Betrieb werden laufend mit dem Test verglichen.
Was das für Sie heisst: Bevor echtes Kapital im Spiel ist, muss das System unter Marktbedingungen zeigen, dass es sich wie im Test verhält.
Updates
Kein Update ohne Identitätsnachweis
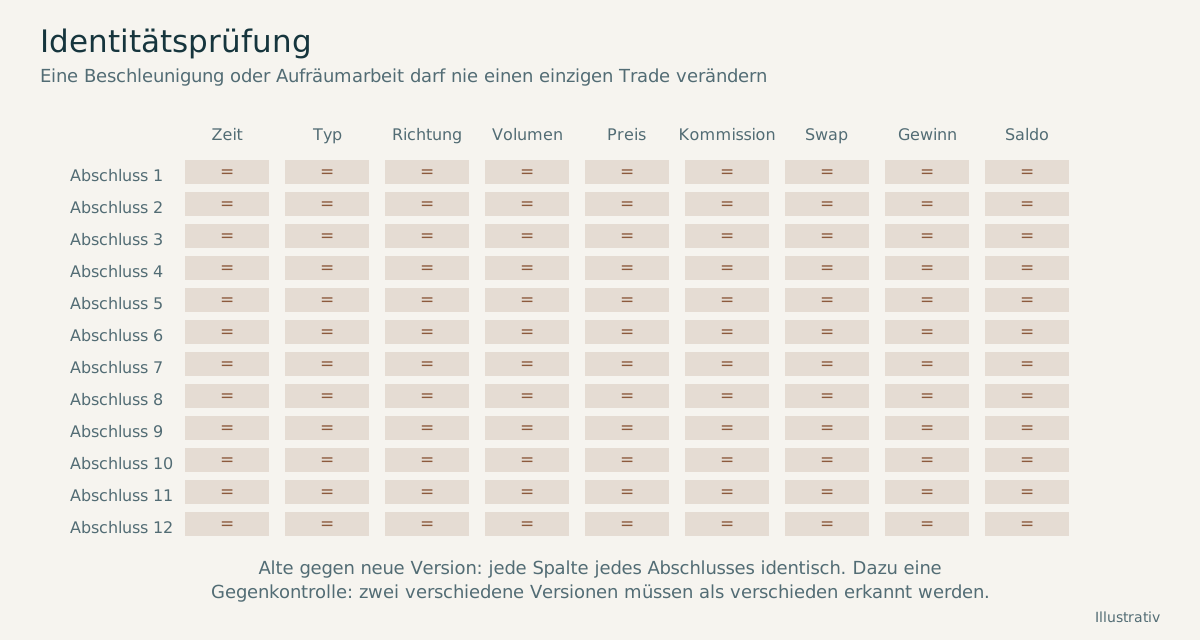
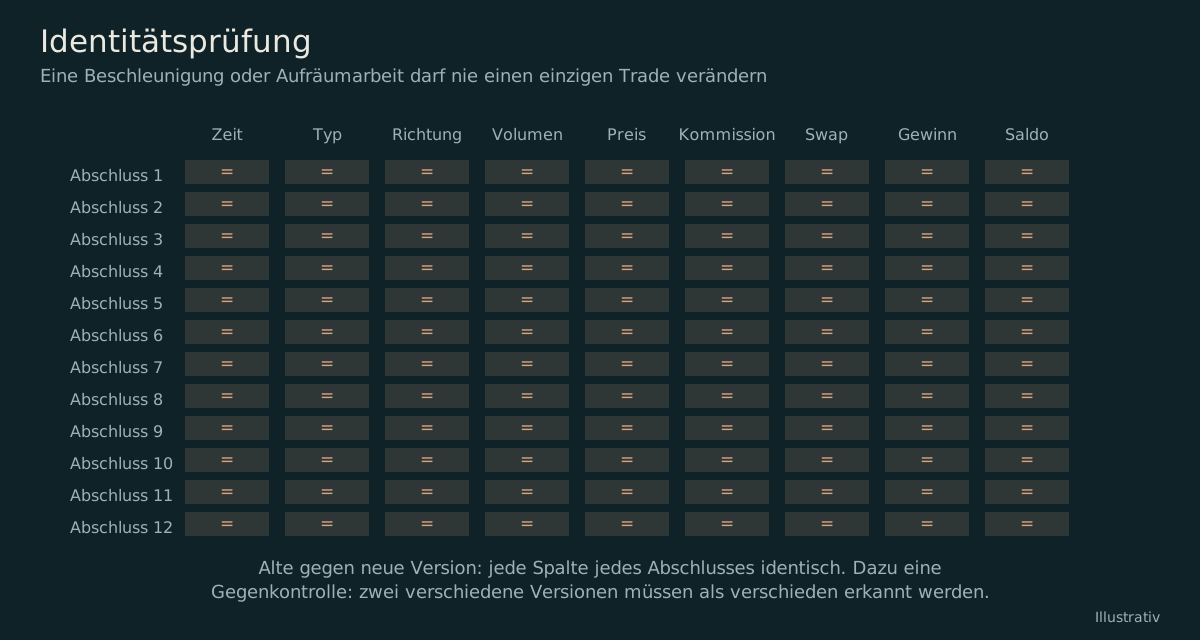
Auch eine reine Beschleunigung oder Aufräumarbeit am Code darf das Verhalten nicht verändern. Bei jeder neuen Version laufen alte und neue Version nebeneinander über alle produktiven Konfigurationen. Jede Spalte jedes einzelnen Trades muss identisch sein. Als Gegenkontrolle muss das Prüfwerkzeug zwei bewusst unterschiedliche Versionen auch als unterschiedlich erkennen.
Danach gibt es genau eine aktive Version. Die Versionsnummer ist im Programm fest eingebaut und wird im Panel angezeigt, damit nie unklar ist, was gerade läuft.
Ein Beispiel: Eine Optimierung des Rechenaufwands pro Kursbewegung machte Testläufe mehr als doppelt so schnell. Übernommen wurde sie erst, nachdem jeder Trade nachweislich identisch war.
Observer
Beobachten statt glauben
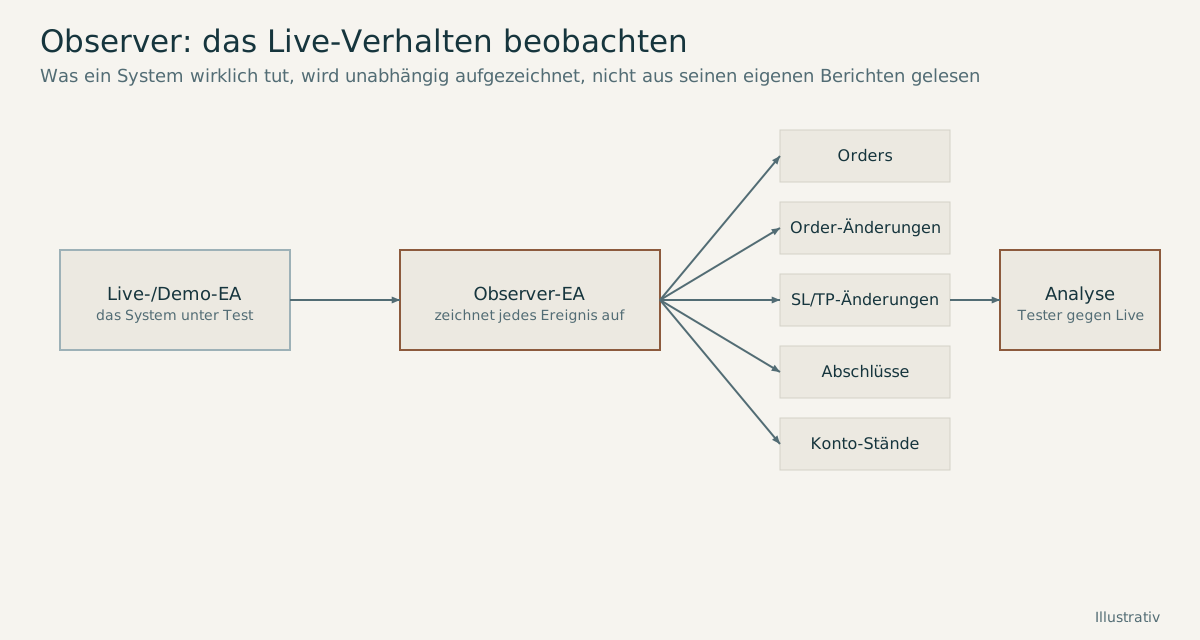
Was ein System wirklich tut, lesen wir nicht nur aus seinen eigenen Berichten ab. Eigene Beobachter-Programme (Observer) laufen parallel auf den Testkonten und zeichnen jedes Ereignis unabhängig auf: neue Orders, Änderungen, Stop- und Zielverschiebungen, Abschlüsse und Kontostände. Damit vergleichen wir Test und Realität Ereignis für Ereignis und können auch das Verhalten fremder Systeme analysieren, deren Code nicht einsehbar ist.
Auch die Beobachter selbst werden geprüft. Fehler in ihren Aufzeichnungen wurden gefunden und in einer neuen Version behoben, wobei die alte Version unverändert erhalten blieb.
Infrastruktur
Die Testinfrastruktur
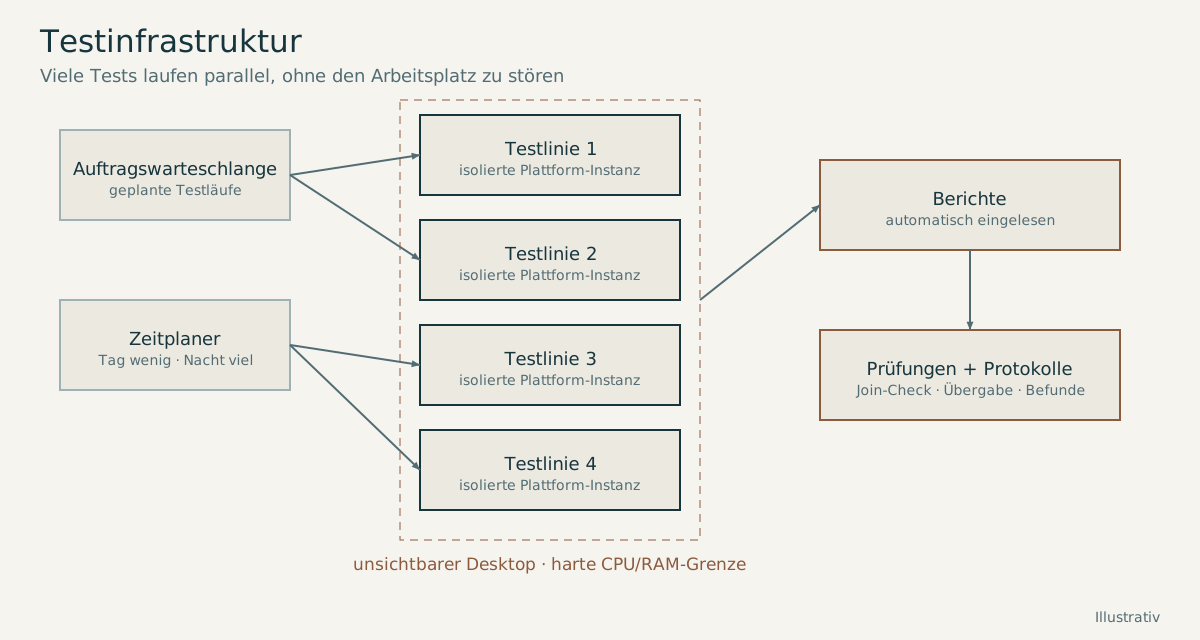
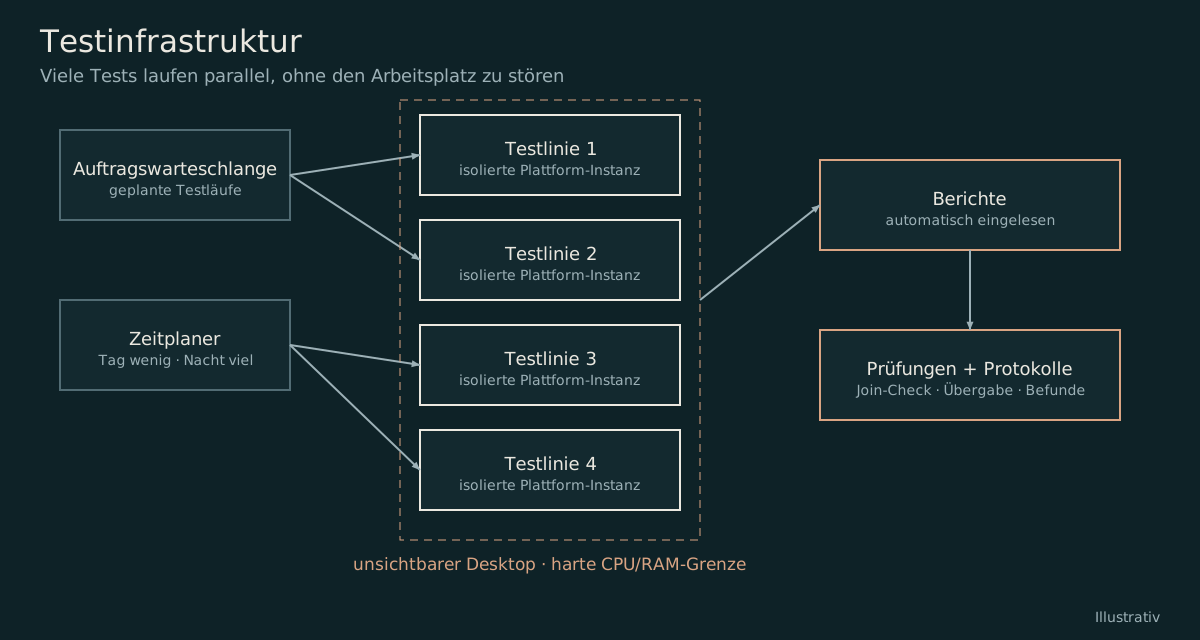
Viele Prüfungen bedeuten viele Testläufe. Sie laufen bei uns parallel auf mehreren isolierten Plattform-Instanzen:
- Auftragswarteschlange. Sie verteilt die geplanten Läufe.
- Zeitplaner. Er begrenzt tagsüber die Zahl gleichzeitiger Tests und gibt nachts mehr Kapazität frei.
- Harte Ressourcengrenze. Alle Tests laufen auf einem unsichtbaren Desktop unter einer Obergrenze für Rechenleistung und Arbeitsspeicher, damit der Arbeitsplatz nie spürbar belastet wird.
- Automatische Berichtsprüfung. Stimmt die Zahl der Abschlüsse mit der Zusammenfassung überein? Ist der Bericht vollständig? Läuft ein Test ins Leere, wird er erkannt und wiederholt, nicht still übernommen.
- Fortlaufende Protokolle. Übergabeprotokoll, Befundliste und Statusmatrix: Jede Arbeitssitzung kann exakt dort weitermachen, wo die letzte aufgehört hat.
- Wissensgraph. Abgeschlossene Befunde werden zusätzlich als Graph abgelegt, damit Zusammenhänge zwischen Erkenntnissen sichtbar bleiben.
Dashboard
Nur geprüfte Berichte kommen ins Dashboard
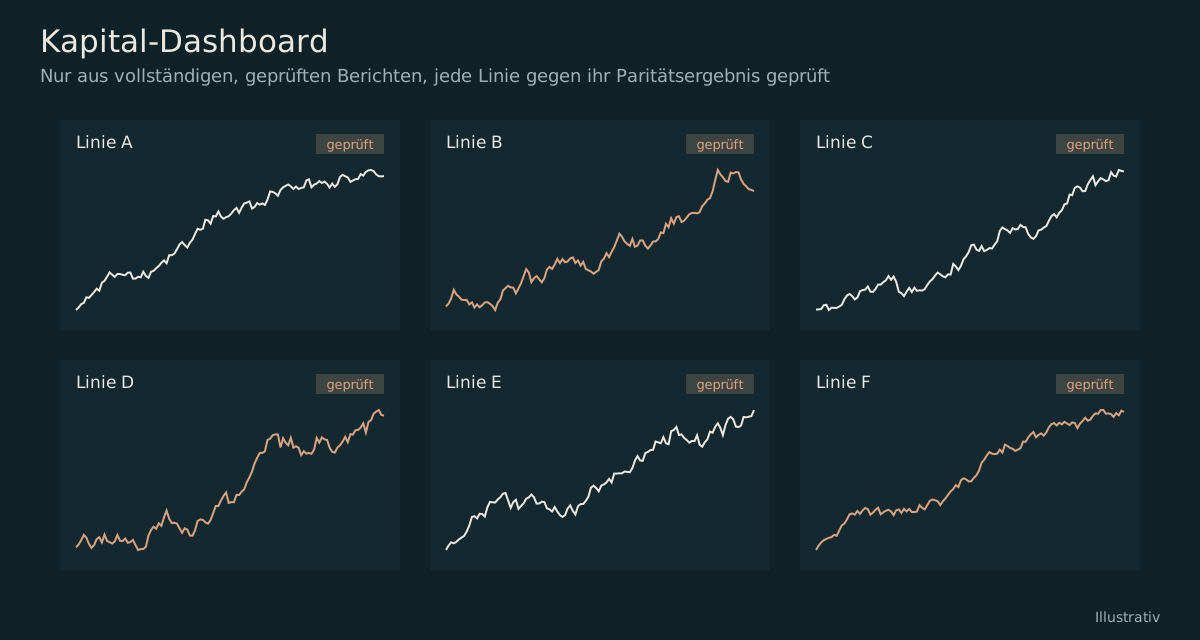
Für den laufenden Betrieb haben wir ein eigenes Kapital-Dashboard gebaut. Es entsteht ausschliesslich aus vollständigen, geprüften Testberichten. Bevor ein Bericht ins Dashboard darf, durchläuft er einen eigenen Prüfstand: Zeitraum, Modellierung, Spread, Einstellungen gegen die erwartete Konfiguration, Trade-Liste, Jahresverteilung und Gegenprobe gegen das Ergebnis der Paritätsprüfung.
Das Dashboard gibt es in mehreren Fassungen: interaktiv im Browser, als statische Version ohne Skripte (läuft auch offline und in Messenger-Vorschauen) und als teilbare Online-Ansicht.
Einen Beispiel-Backtest selbst ausprobieren →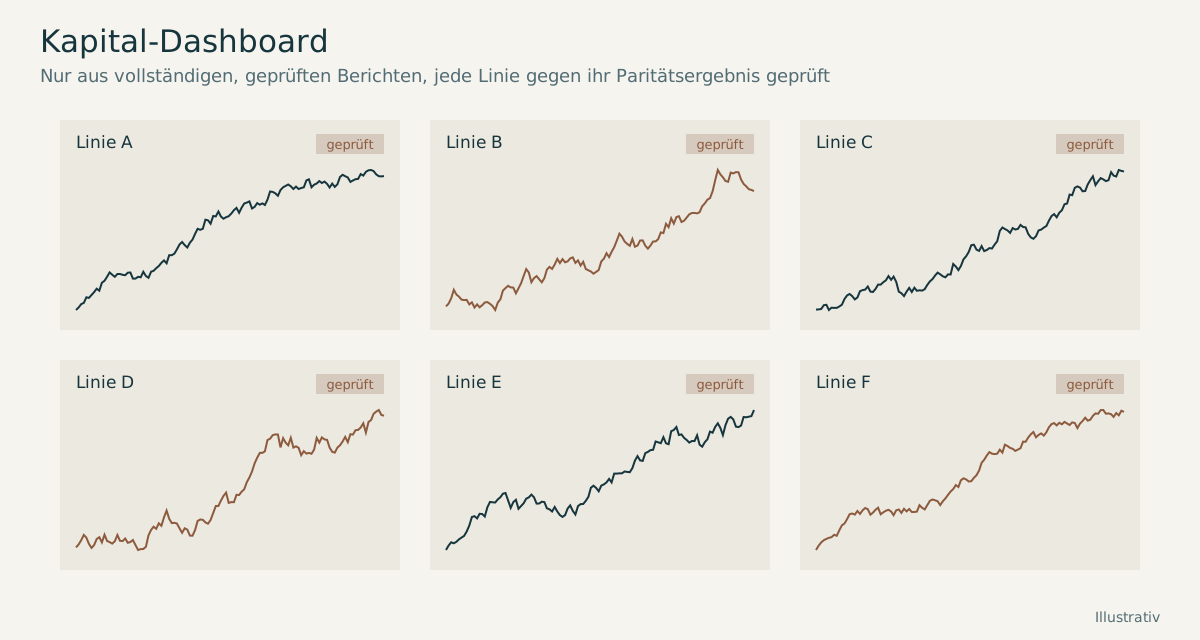
News-Reader
Eine Schutzschicht, kein Signalgeber
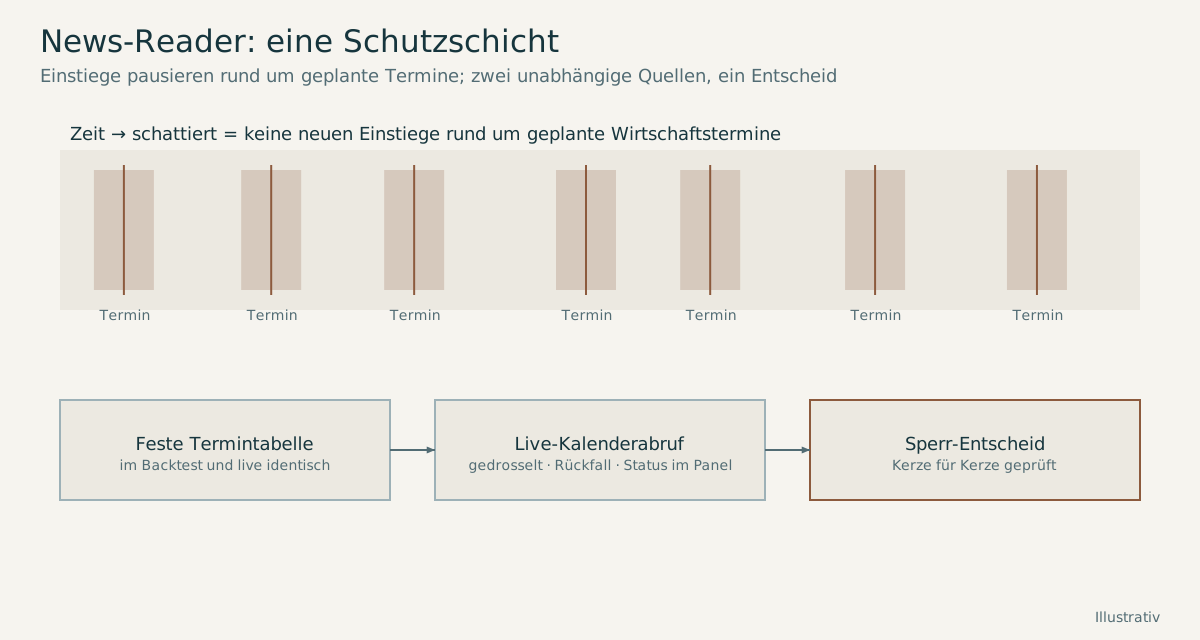
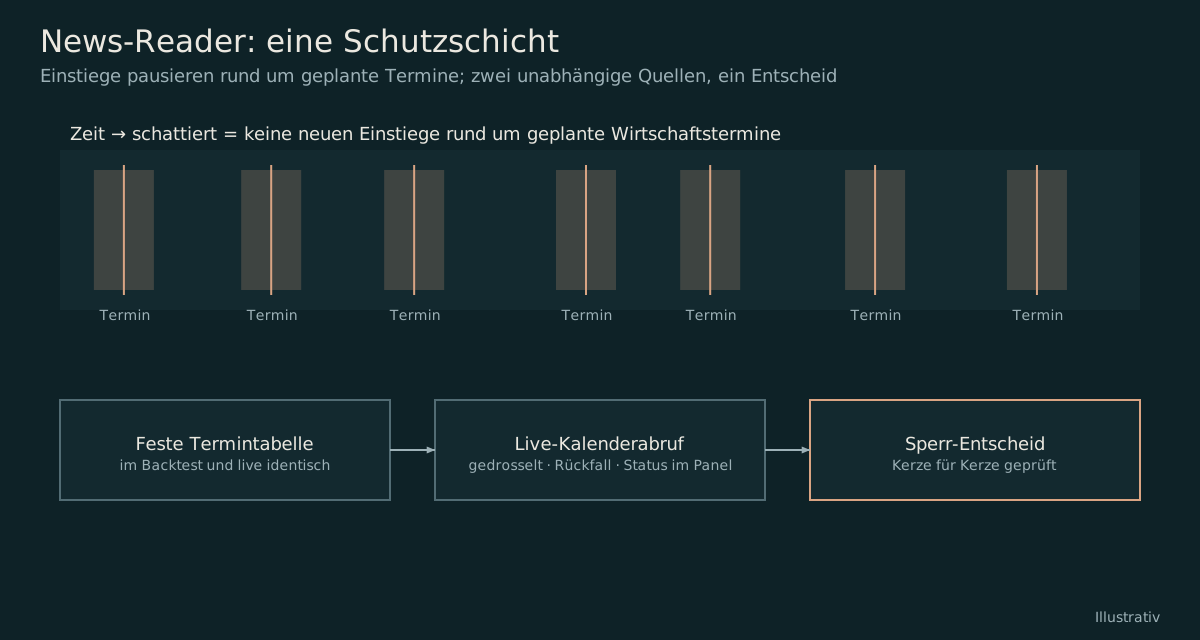
Rund um wichtige Wirtschaftstermine verhalten sich Märkte anders. Unser News-Reader ist deshalb kein Signalgeber, sondern eine reine Schutzschicht: Er pausiert neue Einstiege in einem Fenster um geplante Termine.
Er arbeitet mit zwei unabhängigen Quellen: einer festen Termintabelle, die im Backtest und im Live-Betrieb identisch ist, und einem Live-Abruf des Wirtschaftskalenders. Der Live-Abruf ist gedrosselt, hat eine Rückfallebene und zeigt seinen Zustand im Panel an. Für jeden Markt werden die Termine aus offiziellen Quellen abgeleitet, Uhrzeiten werden nicht angenommen.
Geprüft wird der News-Reader Kerze für Kerze: Treffer und Fehltreffer, Zeitbasis, Fensterbreite, Abdeckung, Gleichheit zwischen Test und Live, und alle Zustände der Anzeige einschliesslich Tabelle abgelaufen.
Fehlerkatalog
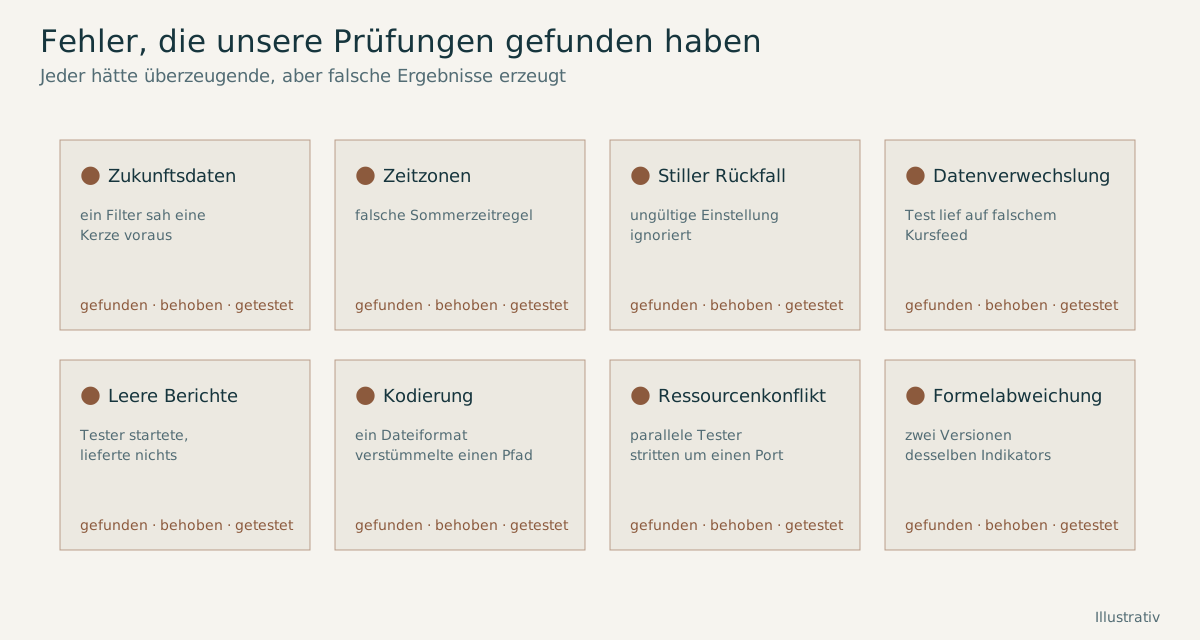
Fehler, die unsere Prüfungen gefunden haben
Jeder dieser Fehler hätte überzeugende, aber falsche Ergebnisse erzeugt:
- Blick in die Zukunft: Ein Filter nutzte eine Kerze, die zum Entscheidungszeitpunkt noch nicht abgeschlossen war.
- Zeitzonen: Eine falsche Sommerzeitregel verschob Handelszeiten.
- Stiller Rückfall: Ein ungültiger Einstellungswert wurde ohne Meldung ignoriert. Eine ganze Testserie lief deshalb mit anderen Einstellungen als gedacht.
- Falsche Datenquelle: Tests liefen auf dem falschen Kursdatensatz und wurden nachträglich für ungültig erklärt.
- Leere Berichte: Die Testplattform startete, lieferte aber kein Ergebnis.
- Kodierung: Ein Dateiformat verstümmelte einen Pfad.
- Ressourcenkonflikt: Parallele Tests stritten sich um denselben Netzwerk-Port.
- Formelabweichung: Zwei Versionen desselben Indikators rechneten leicht unterschiedlich.
- Beschädigte Daten: Eine Kursdatei enthielt nur einen Bruchteil der erwarteten Ticks und wurde aus der Sicherung wiederhergestellt.
Fazit
Warum wir den wenigen vertrauen, die bestehen
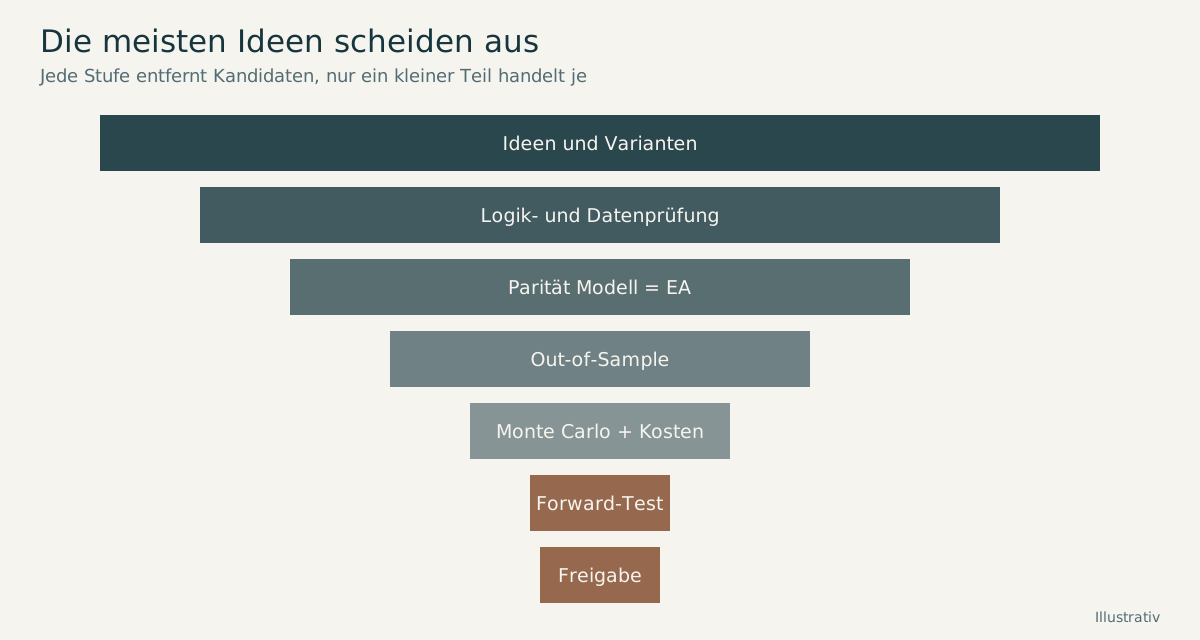
Ein Handelssystem, das fehlerfrei läuft, ist kein Zufall und kein einzelner guter Einfall. Es ist das Ergebnis einer Kette von Prüfungen, von denen jede einzelne eine bestimmte Art von Selbsttäuschung ausschliesst. Die meisten Ideen bestehen diese Kette nicht. Genau deshalb können wir den wenigen vertrauen, die es tun.
Wie geht es weiter?
Zwei Wege, je nachdem, was Sie brauchen.
Prüfung besprechen
Sie möchten verstehen, wie wir ein System prüfen? Wir erklären die Kette gern an einem Beispiel.
Zum Kontaktformular →Entwicklung anfragen
Sie brauchen einen Expert Advisor, ein Copy-System oder eine Anbindung? Schildern Sie uns Ihr Vorhaben.
Zum Kontaktformular →